LLM là gì đang là câu hỏi nền tảng đối với người làm marketing và SEO khi ChatGPT, Gemini hoặc Claude bắt đầu trả lời khách hàng thay cho danh sách kết quả tìm kiếm.
Cả 3 công cụ này đều chạy trên mô hình ngôn ngữ lớn, do đó điều AI nói về một doanh nghiệp phụ thuộc trực tiếp vào cách mô hình học và lấy kiến thức từ đâu.
Bài viết dưới đây sẽ giải thích LLM hoạt động thế nào, phân tích 2 nguồn kiến thức của LLM cùng hệ quả đối với website, đồng thời tổng hợp các mô hình phổ biến tính đến tháng 10/2026, những giới hạn cần biết và cách dùng LLM trong marketing, SEO khi có người duyệt.
LLM Là Gì?
LLM (Large Language Model, mô hình ngôn ngữ lớn) là mô hình AI được huấn luyện trên lượng văn bản rất lớn để dự đoán từ hoặc cụm từ tiếp theo trong văn bản.
Từ khả năng dự đoán đó, LLM viết được câu trả lời, tóm tắt tài liệu và dịch văn bản sang ngôn ngữ khác.
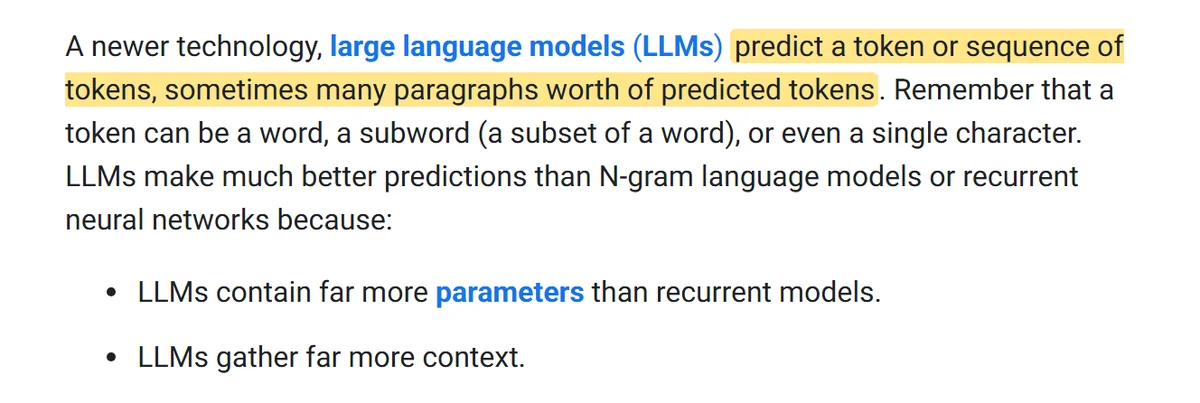
Chữ “lớn” trong tên gọi phản ánh quy mô của mô hình. Theo khóa học Machine Learning Crash Course của Google, các mô hình Transformer dùng để xây dựng LLM chứa hàng trăm tỷ hoặc thậm chí hàng nghìn tỷ tham số.
Tham số là những giá trị mà mô hình tự điều chỉnh trong quá trình học.
Nhờ số lượng tham số rất lớn và khả năng thu nhận nhiều ngữ cảnh hơn, LLM dự đoán tốt hơn các mô hình ngôn ngữ thế hệ trước như mô hình N-gram hoặc mạng nơ-ron hồi quy.
Tính năng gợi ý từ trên bàn phím điện thoại là ví dụ gần nhất với cách LLM làm việc.
Khi bạn gõ “chúc mừng”, bàn phím sẽ gợi ý “sinh nhật” vì đó là từ thường xuất hiện đi kèm nhất. LLM làm đúng việc này ở quy mô lớn hơn nhiều.
Google mô tả LLM “về bản chất là cơ chế tự hoàn thành, có thể tự động dự đoán hàng nghìn token” (bản dịch), trong đó token là đơn vị văn bản nhỏ mà mô hình xử lý.
Do đó, một câu trả lời dài trong khung chat là kết quả của hàng nghìn lần dự đoán nối tiếp nhau.
LLM Hoạt Động Như Thế Nào?
LLM hoạt động bằng cách chia văn bản thành các token, dùng kiến trúc Transformer để hiểu mối quan hệ giữa các token rồi dự đoán lần lượt từng token tiếp theo cho tới khi hoàn thiện câu trả lời. Khả năng dự đoán này được hình thành qua 2 giai đoạn gồm huấn luyện trước và tinh chỉnh.
Để làm rõ cơ chế bên trong, 3 phần dưới đây sẽ lần lượt giải thích token, kiến trúc Transformer và 2 giai đoạn huấn luyện tạo ra một LLM.
Token Và Cách LLM Dự Đoán Từ Tiếp Theo
Token là đơn vị nhỏ nhất mà LLM xử lý, có thể là một từ, một phần của từ hoặc một ký tự. Đối với mỗi chỗ trống trong câu, LLM tính xác suất của nhiều token có thể điền vào, chọn ra một token rồi lặp lại bước này cho token kế tiếp.
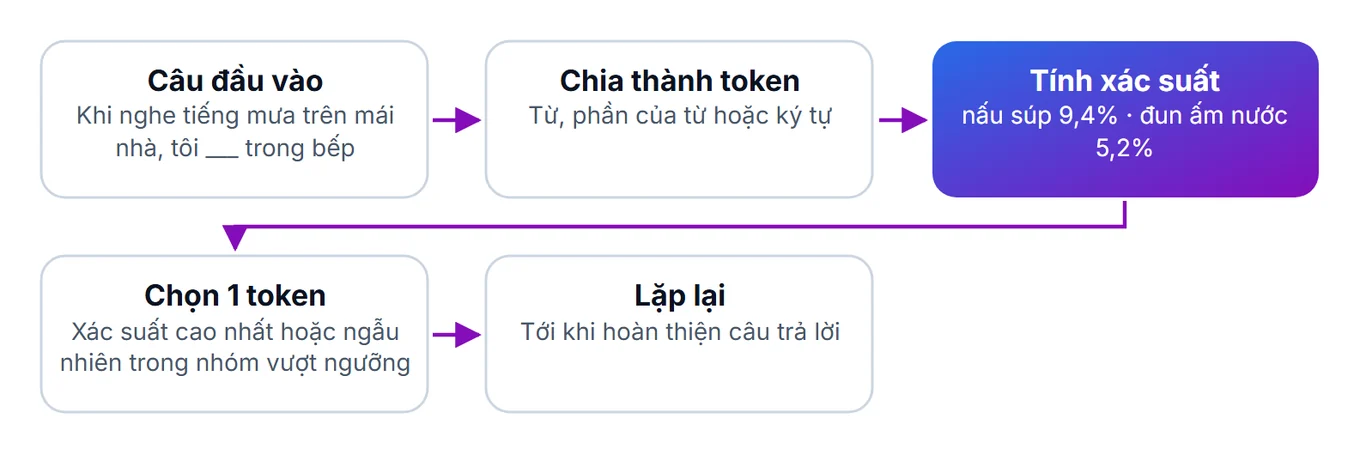
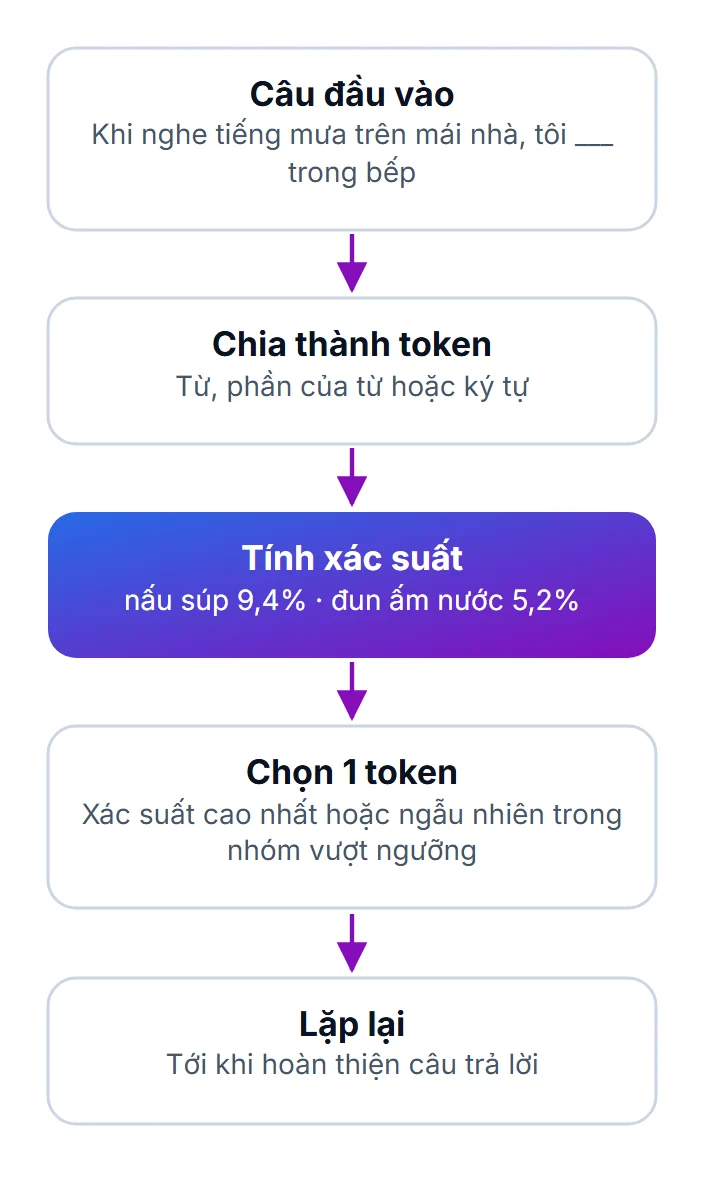
Google minh họa cơ chế này bằng câu “Khi nghe tiếng mưa trên mái nhà, tôi ___ trong bếp” (bản dịch).
Đối với câu này, mô hình xếp các khả năng điền vào chỗ trống theo xác suất. Khả năng cao nhất là “nấu súp” đạt 9,4%, tiếp theo là “đun ấm nước” 5,2%, “thu mình lại” 3,6%, “chợp mắt” 2,5% và “thư giãn” 2,2%.
Ứng dụng có thể chọn khả năng đạt xác suất cao nhất hoặc chọn ngẫu nhiên trong nhóm vượt một ngưỡng nhất định. Chính cơ chế chọn này khiến cùng một câu hỏi có thể nhận về 2 câu trả lời khác nhau ở 2 lần hỏi.
Số lượng ký tự trong một token khác nhau theo từng ngôn ngữ. Theo Google, đối với tiếng Anh, 1 token tương đương khoảng 4 ký tự, tức là 400 token tương đương khoảng 300 từ.
Token cũng là đơn vị đo lường mà doanh nghiệp gặp khi dùng LLM. Lượng văn bản mô hình xử lý được trong một lần gọi là cửa sổ ngữ cảnh (context window) và được tính bằng token.
Theo trang mô hình của OpenAI và Anthropic, con số này là khoảng 1,05 triệu token đối với GPT-6 Astra và 1 triệu token đối với 4 mô hình Claude mới nhất. Giá sử dụng qua API cũng tính theo số token đầu vào và đầu ra.
Công cụ dưới đây ước tính số token và chi phí gọi API cho 3 thông số gồm số từ gửi vào, số từ nhận về và số lần gọi mỗi tháng:
Ước tính theo tỷ lệ Google nêu cho tiếng Anh và giá GPT-6 Astra OpenAI niêm yết ngày 30/10/2026 · không phải hóa đơn thực tế
Token vào: 2.000
Token ra: 1.000
Mỗi lần gọi: 0,07 USD
Mỗi tháng: 70 USD
Cách tính: số token bằng số từ nhân 4/3 (400 token tương đương khoảng 300 từ). Giá GPT-6 Astra là 10 USD cho mỗi 1 triệu token đầu vào và 50 USD cho mỗi 1 triệu token đầu ra. Tỷ lệ từ và token chỉ áp cho tiếng Anh, văn bản tiếng Việt cần đếm lại bằng công cụ đếm token của từng hãng.
Với mức mặc định, mỗi lần gọi gửi 1.500 từ và nhận về 750 từ tương đương khoảng 2.000 token đầu vào và 1.000 token đầu ra. Chi phí khoảng 0,07 USD mỗi lần, tức khoảng 70 USD cho 1.000 lần gọi một tháng. Phần đầu ra có giá cao gấp 5 lần đầu vào, nên câu trả lời dài làm chi phí tăng nhanh hơn tài liệu dài.
Transformer Giúp LLM Hiểu Ngữ Cảnh Như Thế Nào?
Transformer là kiến trúc mạng nơ-ron ra mắt năm 2017 trong bài báo “Attention Is All You Need” và là kiến trúc phổ biến nhất để xây dựng LLM. Trọng tâm của Transformer là cơ chế tự chú ý (self-attention), giúp mỗi token xét xem các token còn lại ảnh hưởng tới nghĩa của nó ra sao.
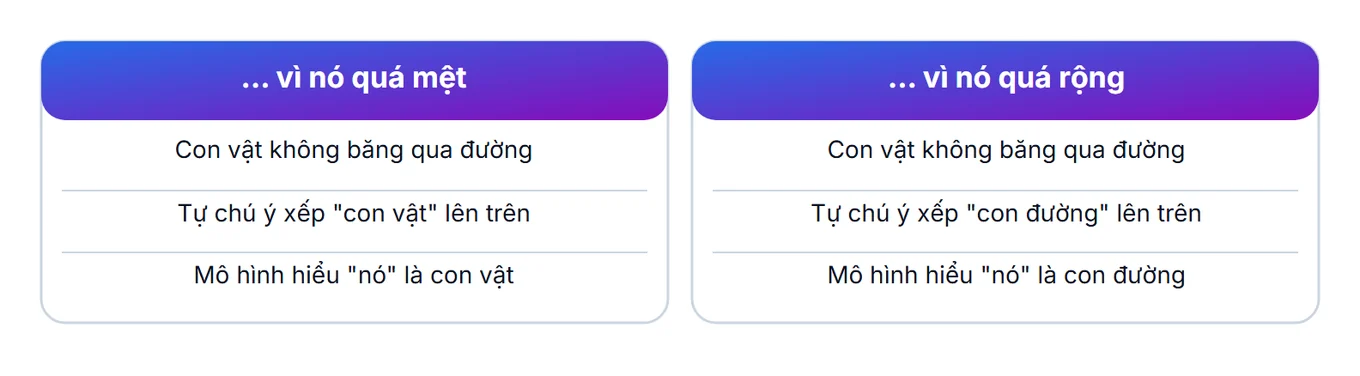
Google dùng câu “Con vật không băng qua đường vì nó quá mệt” (bản dịch) để minh họa. Đối với người đọc, từ “nó” rõ ràng là “con vật”. Tuy nhiên, đối với máy tính thì đây là việc khó vì chữ “nó” cũng có thể chỉ “con đường”.
Cơ chế tự chú ý sẽ tính mức độ liên quan của từng từ trong câu đối với từ “nó” và xác định “con vật” quan trọng hơn “con đường”. Khi câu đổi thành “vì nó quá rộng”, cơ chế này sẽ xếp “con đường” lên trên. Nhờ vậy, mô hình giữ đúng nghĩa của cả câu thay vì chỉ nhìn vài từ đứng cạnh nhau.
Bài báo năm 2017 của Ashish Vaswani cùng 7 đồng tác giả đã đề xuất một kiến trúc “chỉ dựa trên cơ chế attention, loại bỏ hoàn toàn cấu trúc hồi quy và tích chập” (bản dịch). Chữ T trong GPT cũng là Transformer vì GPT là viết tắt của Generative Pre-trained Transformer.
Huấn Luyện Trước Và Tinh Chỉnh Khác Nhau Thế Nào?
Huấn luyện trước (pre-training) cho LLM học từ lượng văn bản rất lớn để nắm ngữ pháp, từ vựng và kiến thức chung, tạo ra mô hình nền tảng (foundation model). Tinh chỉnh (fine-tuning) huấn luyện thêm mô hình nền tảng cho một nhiệm vụ cụ thể, đôi khi chỉ với vài trăm tới vài nghìn ví dụ.
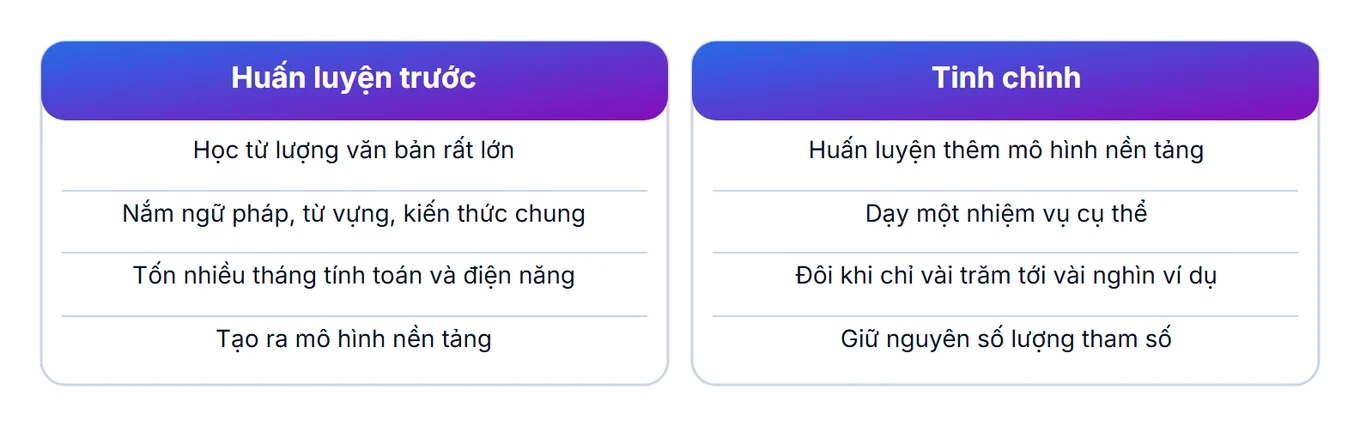
Giai đoạn huấn luyện trước tốn kém chi phí nhất. Google liệt kê các khó khăn gồm việc thu thập một tập dữ liệu khổng lồ, tiêu tốn nhiều tháng cùng lượng tài nguyên tính toán và điện năng rất lớn.
Ngược lại, tinh chỉnh nhẹ nhàng hơn nhiều vì chỉ dạy thêm một việc cụ thể, ví dụ như phân loại email khách hàng. Sau khi tinh chỉnh, mô hình vẫn giữ nguyên số lượng tham số của mô hình nền tảng.
Đối với doanh nghiệp, điểm cần nhớ nằm ở hệ quả của 2 giai đoạn này. Kiến thức mà mô hình học được nằm trong tham số và dừng lại tại thời điểm huấn luyện. Đây là lý do khiến LLM cần thêm một nguồn kiến thức thứ hai.
LLM Lấy Kiến Thức Từ Đâu?
LLM lấy kiến thức từ 2 nguồn. Nguồn thứ nhất là dữ liệu huấn luyện được lưu trong tham số của mô hình và dừng lại ở một mốc cắt dữ liệu. Nguồn thứ hai là thông tin được truy xuất từ web hoặc kho tài liệu ngay lúc trả lời, thường gọi là RAG.
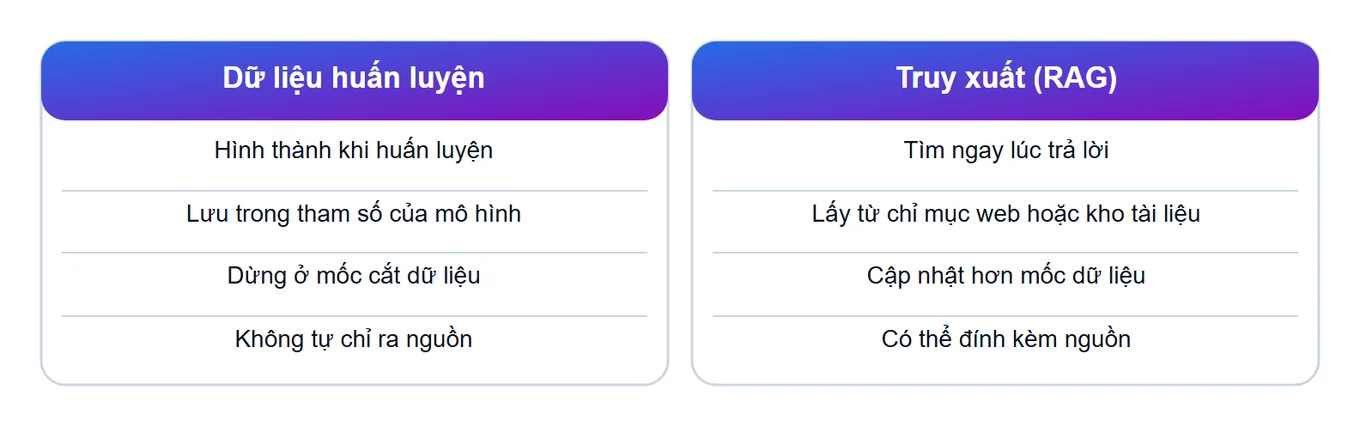
Giới hạn của nguồn thứ nhất đã được chính giới nghiên cứu nêu ra từ năm 2020. Trong bài báo giới thiệu RAG, nhóm tác giả của Patrick Lewis ghi nhận mô hình ngôn ngữ lưu kiến thức thực tế trong tham số.
Tuy vậy, việc “nêu nguồn gốc cho các quyết định và cập nhật kiến thức về thế giới vẫn là những bài toán nghiên cứu còn bỏ ngỏ”. Nói cách khác, mô hình biết nhiều nhưng không tự biết thông tin mới và không tự chỉ ra được mình biết điều đó từ đâu.
Để làm rõ cơ chế này, 3 phần dưới đây sẽ đi qua mốc cắt dữ liệu, cách RAG bổ sung thông tin mới và điều kiện để trang của doanh nghiệp được truy xuất.
Dữ Liệu Huấn Luyện Luôn Dừng Ở Một Mốc Cắt Dữ Liệu
Mốc cắt dữ liệu (knowledge cutoff) là thời điểm cuối cùng của dữ liệu dùng để huấn luyện một LLM. Sự kiện, bảng giá hoặc sản phẩm xuất hiện sau mốc này không nằm trong tham số của mô hình. Do đó, khi không truy xuất thêm, LLM có thể trả lời bằng thông tin cũ hoặc đoán sai.
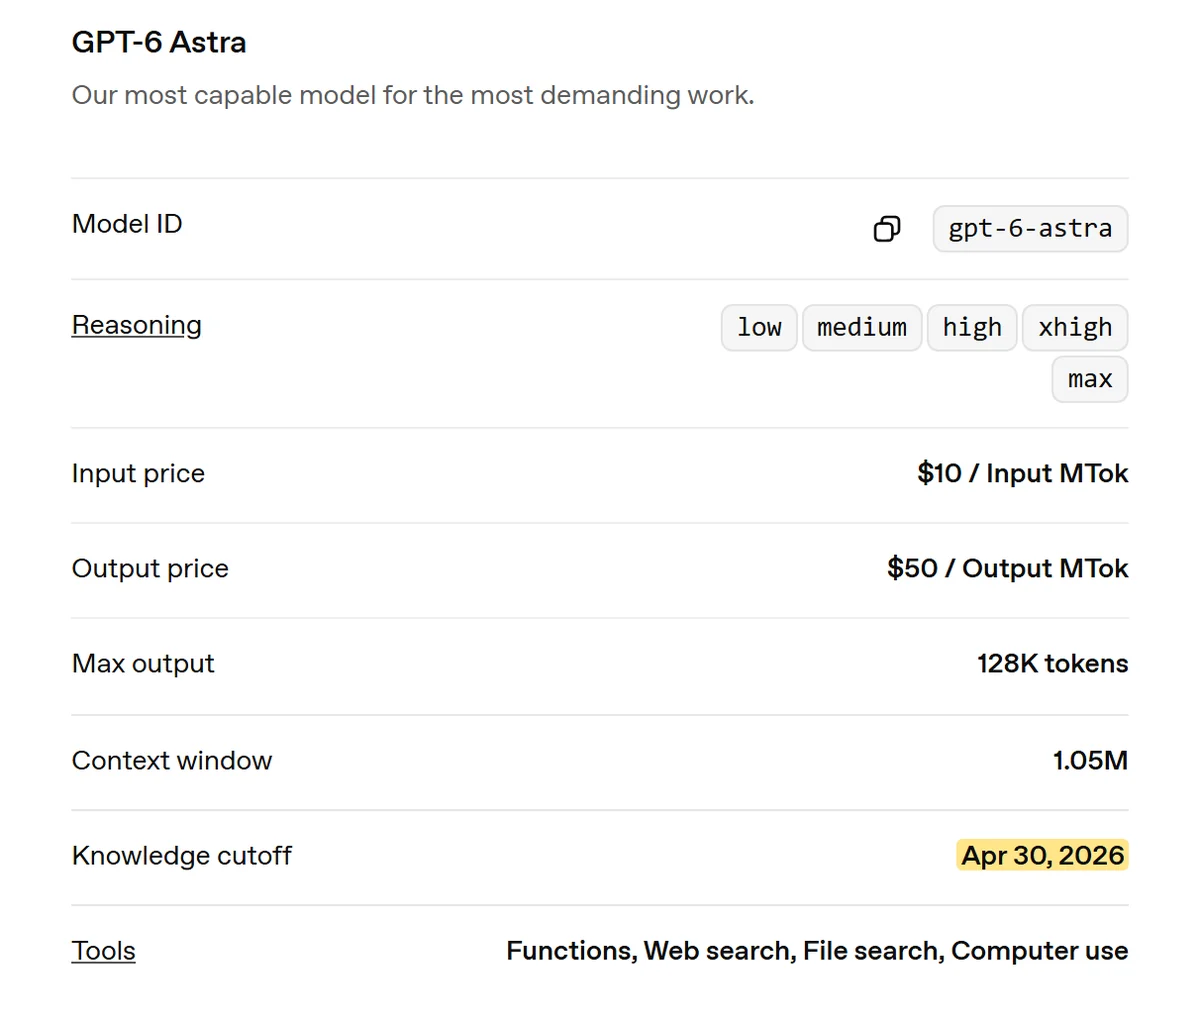
Ngày 30/10/2026, đội ngũ GTV SEO mở trang mô hình chính thức của 3 hãng lớn để ghi lại mốc dữ liệu và thấy 3 cách công bố khác nhau:
- OpenAI: Trang mô hình ghi nhận GPT-6 Astra và GPT-6.1 Sol có cùng mốc dữ liệu (knowledge cutoff) là ngày 30/04/2026.
- Anthropic: Trang mô hình tách 2 loại mốc đối với Claude là mốc kiến thức đáng tin cậy (reliable knowledge cutoff) và mốc dữ liệu huấn luyện (training data cutoff). Đối với 4 mô hình mới nhất, cả 2 mốc đều là tháng 6/2026.
- Google: Trang mô hình Gemini 4 Argon không ghi mốc dữ liệu mà chỉ ghi lần cập nhật gần nhất (Latest update) là tháng 10/2026.
Việc Anthropic tách 2 loại mốc cho thấy chính hãng phát triển phân biệt dữ liệu đã đưa vào huấn luyện với phần kiến thức mô hình nắm đủ chắc. Đối với doanh nghiệp, hệ quả rất cụ thể.
Một bảng giá, tên dịch vụ hoặc địa chỉ văn phòng thay đổi sau mốc dữ liệu sẽ không có trong kiến thức gốc của mô hình. Thông tin mới chỉ đến được với mô hình khi được truy xuất ở nguồn thứ hai.
RAG Là Gì? Cách LLM Truy Xuất Thông Tin Mới
RAG (Retrieval-Augmented Generation, tạo sinh có tăng cường truy xuất) là cách cho LLM tìm tài liệu liên quan trước, sau đó viết câu trả lời dựa trên những đoạn vừa tìm được. Nhờ bước tìm kiếm này, câu trả lời cập nhật hơn mốc dữ liệu và đính kèm được nguồn để người đọc kiểm tra.
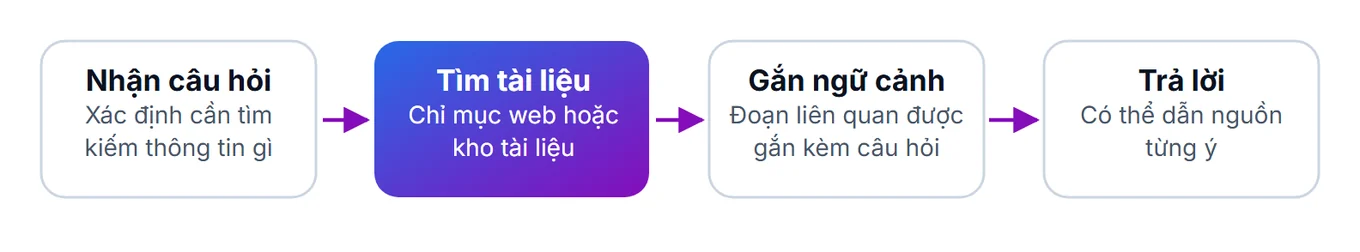
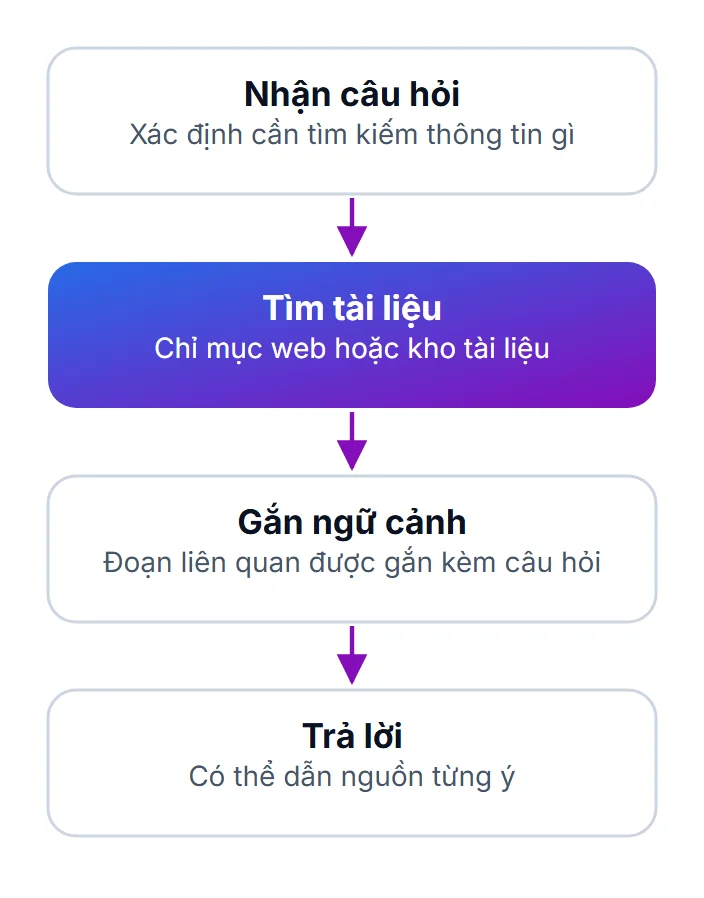
Cách RAG xử lý một câu hỏi có thể chia thành 4 bước đơn giản:
- Nhận câu hỏi: Hệ thống đọc câu hỏi của người dùng và xác định cần tìm kiếm thông tin gì.
- Tìm tài liệu: Bộ truy xuất (retriever) tìm các trang hoặc đoạn văn liên quan trong chỉ mục web hoặc trong kho tài liệu của doanh nghiệp.
- Gắn ngữ cảnh: Những đoạn vừa tìm được sẽ gắn kèm câu hỏi rồi chuyển cho LLM đọc.
- Trả lời kèm nguồn: LLM viết câu trả lời dựa trên các đoạn đó và có thể dẫn nguồn cho từng ý.
Trong 4 bước này, bước tìm tài liệu quyết định câu trả lời có cập nhật hay không, vì LLM chỉ đọc được những đoạn mà bộ truy xuất tìm thấy.
Ví dụ minh họa dễ nhớ là 2 kiểu làm bài thi. LLM không có RAG giống thí sinh làm bài thi đề đóng, tức là chỉ dựa vào những gì đã học thuộc. Ngược lại, LLM có RAG giống thí sinh được mang tài liệu vào phòng thi, trả lời được câu hỏi mới nếu tài liệu đúng và đầy đủ.
Khái niệm RAG được Patrick Lewis và 11 cộng sự công bố trong bài báo nộp ngày 22/05/2020. Ở phiên bản gốc, bộ nhớ bên ngoài là một chỉ mục của Wikipedia. Nhóm tác giả ghi nhận câu trả lời của mô hình RAG “cụ thể hơn, đa dạng hơn và đúng sự thật hơn” so với mô hình chỉ dựa vào tham số (bản dịch).
Các sản phẩm AI hiện nay dùng nguyên tắc này dưới nhiều tên gọi. Google gọi tính năng tương ứng là grounding với Google Search, giúp Gemini đưa ra câu trả lời chính xác hơn và “trích dẫn nguồn kiểm chứng được, vượt ra ngoài mốc dữ liệu” (bản dịch).
Perplexity cũng tìm kiếm trên web theo thời gian thực trước khi tổng hợp câu trả lời.
Website Phải Được Crawl Và Index Mới Có Cơ Hội Vào Câu Trả Lời AI
Bước truy xuất của RAG chỉ tìm được những trang mà hệ thống đã thu thập (crawl) và đưa vào chỉ mục (index). Vì vậy, website muốn xuất hiện trong câu trả lời của AI phải cho bot truy cập và có trang được lập chỉ mục. Đây là điều kiện cần, chưa bảo đảm trang được trích dẫn.
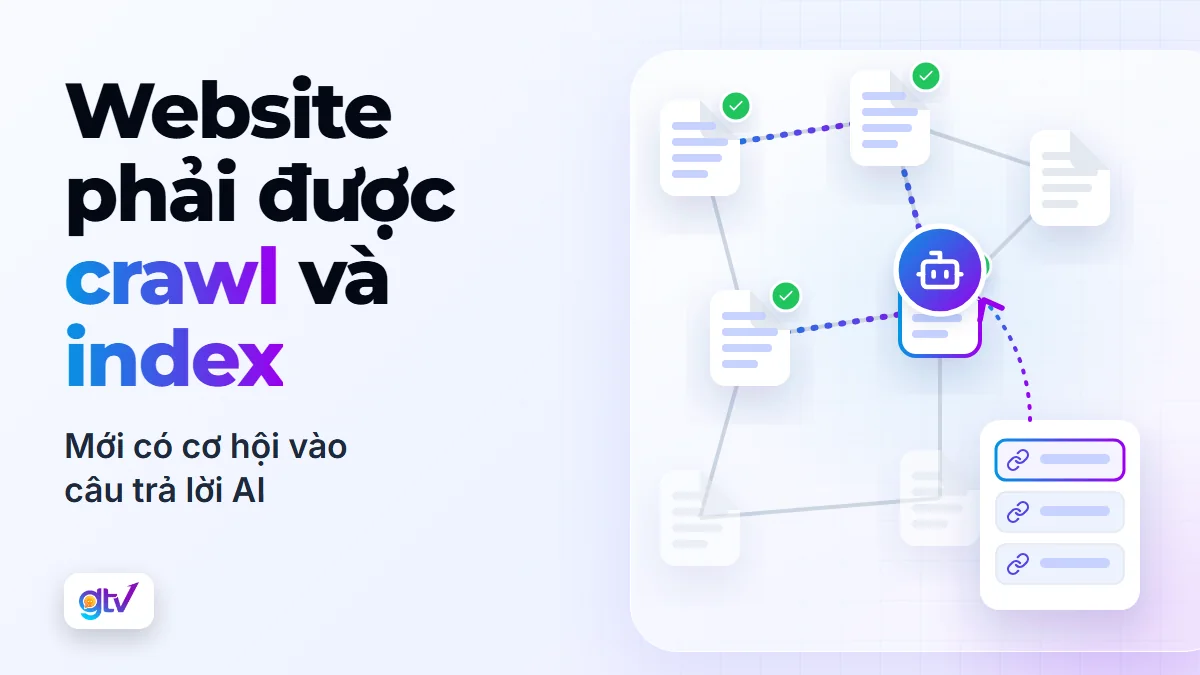
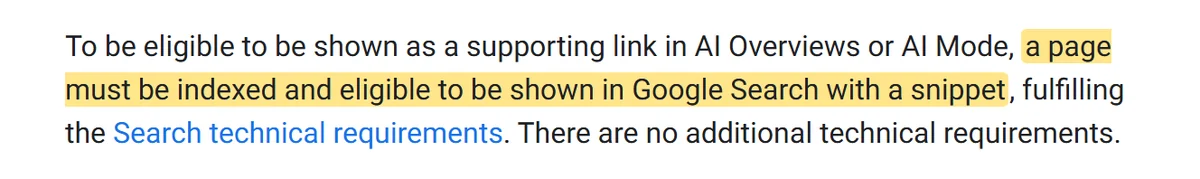
Google nêu rõ điều kiện này đối với các tính năng AI trên Google Search. Để được hiển thị làm liên kết hỗ trợ trong AI Overviews hoặc AI Mode, một trang phải được lập chỉ mục và đủ điều kiện hiển thị kèm đoạn trích.
Google không đặt thêm yêu cầu kỹ thuật nào khác. Điều này có nghĩa là nền tảng để vào câu trả lời của AI trên Google vẫn là việc trang được crawl và index đúng cách.
OpenAI cho thấy ranh giới giữa 2 nguồn kiến thức rõ hơn khi tách 2 bot cho 2 mục đích khác nhau. GPTBot thu thập nội dung có thể dùng để huấn luyện các mô hình nền tảng, tức là phục vụ nguồn thứ nhất.
OAI-SearchBot dùng để hiển thị website trong tính năng tìm kiếm của ChatGPT, tức là phục vụ nguồn thứ hai. Mỗi thiết lập cho 2 bot này hoạt động độc lập.
Hệ quả là website chặn GPTBot vẫn có thể xuất hiện trong ChatGPT Search. Ngược lại, website chặn OAI-SearchBot sẽ không xuất hiện trong câu trả lời tìm kiếm của ChatGPT, dù vẫn có thể xuất hiện dưới dạng liên kết điều hướng.
Từ cơ chế 2 nguồn, đội ngũ GTV SEO nhận thấy 3 lý do thường gặp khiến AI trả lời sai hoặc dùng thông tin cũ về một thương hiệu:
- Thông tin mới hơn mốc dữ liệu: Doanh nghiệp vừa đổi giá hoặc ra dịch vụ mới, trong khi lần trả lời đó không truy xuất web. Lúc này, LLM chỉ còn kiến thức cũ trong tham số để trả lời.
- Trang không truy cập được hoặc chưa được lập chỉ mục: Bước truy xuất không tìm thấy trang chính thức của doanh nghiệp. Câu trả lời lúc đó phải dựa vào nguồn khác hoặc vào phỏng đoán.
- Nguồn bên ngoài đã cũ hoặc sai: Các bài báo, danh bạ hoặc trang đánh giá ghi thông tin lỗi thời được truy xuất thay cho trang chính thức.
Cả 3 lý do đều dẫn tới cùng một việc cần làm trước tiên là kiểm tra xem các trang quan trọng đã được crawl, index và mở cho bot tìm kiếm của AI truy cập chưa. Việc tối ưu nội dung để được trích dẫn chỉ có ý nghĩa sau bước này.
3 câu hỏi dưới đây giúp kiểm tra lại cách phân biệt 2 nguồn kiến thức của LLM và điều kiện để website được AI truy xuất:
Doanh nghiệp vừa đổi bảng giá tuần trước. Một người hỏi chatbot ở chế độ không tìm kiếm trên web. Câu trả lời sẽ dựa vào đâu?
Đáp án. Khi không truy xuất web, LLM chỉ còn kiến thức trong tham số và kiến thức này dừng ở mốc cắt dữ liệu. Bảng giá đổi sau mốc đó không có trong mô hình.
Website chặn GPTBot nhưng vẫn cho OAI-SearchBot truy cập. Trang có thể xuất hiện trong ChatGPT Search không?
Đáp án. GPTBot thu thập nội dung có thể dùng để huấn luyện mô hình, còn OAI-SearchBot dùng để hiển thị website trong tính năng tìm kiếm của ChatGPT. Mỗi thiết lập cho 2 bot này hoạt động độc lập.
Theo Google, trang cần điều kiện gì để được hiển thị làm liên kết hỗ trợ trong AI Overviews hoặc AI Mode?
Đáp án. Google ghi rõ trang chỉ cần được lập chỉ mục và đủ điều kiện hiển thị kèm đoạn trích, không có thêm yêu cầu kỹ thuật nào khác.
Câu nào chọn sai thì phần giải thích ngay dưới đáp án chỉ ra ý cần đọc lại trong phần LLM lấy kiến thức từ đâu.
LLM Khác ChatGPT Thế Nào?
LLM là mô hình, còn ChatGPT là sản phẩm được xây dựng trên LLM. ChatGPT do OpenAI phát triển, chạy trên các mô hình GPT và có thêm giao diện trò chuyện cùng công cụ tìm kiếm trên web. Bạn có thể hình dung LLM là động cơ, còn ChatGPT là chiếc xe hoàn chỉnh lắp động cơ đó.
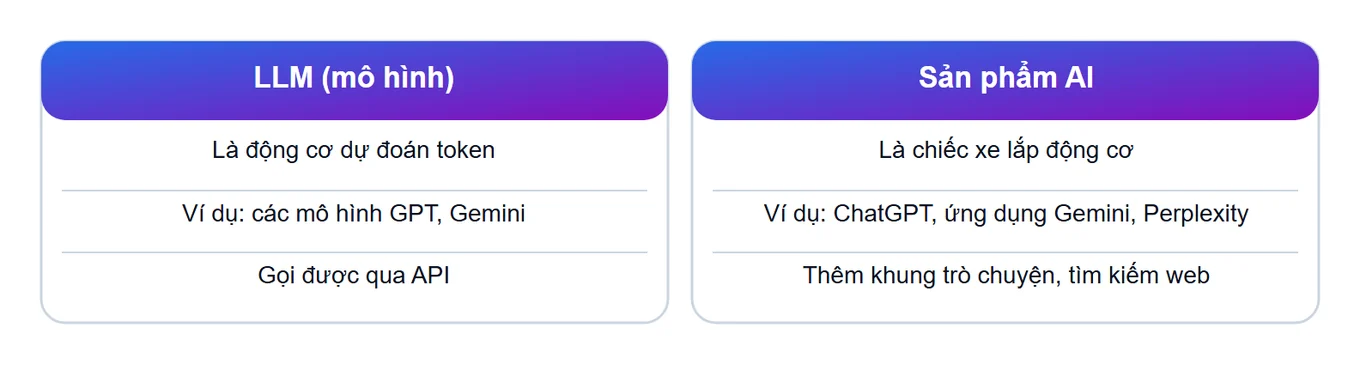
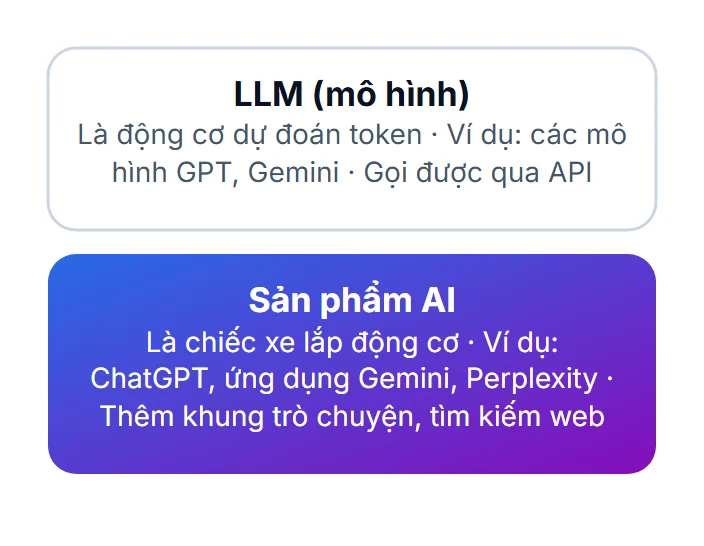
Cách phân biệt này cũng áp dụng cho các công cụ AI quen thuộc khác. Ứng dụng Gemini chạy trên các mô hình Gemini của Google, còn Perplexity cho phép người dùng gói Pro chọn mô hình của nhiều hãng khác nhau cho từng câu hỏi.
Một doanh nghiệp cũng có thể gọi thẳng mô hình GPT qua API để dựng công cụ riêng mà không cần mở ChatGPT.
Do đó, khi so sánh ChatGPT với Gemini, người dùng thật ra đang so sánh 2 sản phẩm có giao diện, công cụ và cách thiết lập khác nhau chứ không chỉ so sánh 2 LLM. Cùng một mô hình vẫn có thể trả lời khác nhau khi được gọi qua API và khi dùng trong ứng dụng có bật tìm kiếm.
Các LLM Phổ Biến Tính Đến Tháng 10/2026
Tính đến tháng 10/2026, các LLM phổ biến gồm GPT của OpenAI, Gemini của Google, Claude của Anthropic, Llama và Muse của Meta, DeepSeek của công ty cùng tên và Qwen của Alibaba. Tại Việt Nam, Viettel AI đã công bố mô hình tiếng Việt VT-Super-120B-A12B.
Do tên phiên bản thay đổi liên tục, bảng dưới đây tổng hợp 7 dòng mô hình theo hãng phát triển và điểm nổi bật được ghi trên trang chính chủ ngày 30/10/2026:
| Mô hình | Hãng phát triển | Điểm nổi bật |
|---|---|---|
| GPT-6 Astra, GPT-6.1 Sol | OpenAI | Astra là mô hình chủ lực cho suy luận phức tạp và lập trình, Sol cân bằng giữa năng lực và chi phí. Mốc dữ liệu 30/04/2026 |
| Gemini 4 Argon | Mô hình suy luận chủ lực, cửa sổ ngữ cảnh khoảng 1 triệu token và hỗ trợ grounding với Google Search | |
| Claude Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 | Anthropic | Cả 4 mô hình có cùng mốc kiến thức đáng tin cậy và mốc dữ liệu huấn luyện là tháng 6/2026 |
| Llama 4, dòng Muse | Meta | Llama 4 là mô hình đa phương thức dùng kiến trúc hỗn hợp chuyên gia (mixture-of-experts). Muse Spark Open là mô hình mở trọng số (open-weight) |
| DeepSeek-V4.1-Flash-1017, DeepSeek V4 Pro | DeepSeek | Bản V4.1 Flash được phát hành mã nguồn mở trên Hugging Face, đi kèm API tìm kiếm riêng của hãng |
| Qwen3.8-Max | Alibaba | Mô hình dành cho suy luận phức tạp và lập trình trên Alibaba Cloud Model Studio |
| VT-Super-120B-A12B | Viettel AI | Mô hình tiếng Việt 120 tỷ tham số, xây dựng trên kiến trúc mở NVIDIA Nemotron 3 Super |
Đối với doanh nghiệp, lựa chọn mô hình phụ thuộc vào việc cần làm hơn là vào tên tuổi của mô hình. Mô hình mở trọng số như Llama, Muse Spark Open hoặc DeepSeek phù hợp khi cần tự vận hành trên máy chủ riêng để giữ dữ liệu trong nội bộ.
Ngược lại, các mô hình GPT, Gemini và Claude dùng qua API hoặc ứng dụng sẽ phù hợp khi cần dùng ngay mà không đầu tư hạ tầng.
Giới Hạn Của LLM: Mạnh, Yếu Và Rủi Ro
LLM mạnh ở khả năng viết rõ ràng nhưng yếu về độ chính xác vì mô hình có thể ảo giác, mang thiên lệch từ dữ liệu và thiếu thông tin sau mốc dữ liệu. Rủi ro lớn nhất với doanh nghiệp là dùng câu trả lời chưa kiểm chứng hoặc dán dữ liệu nội bộ vào công cụ AI.
Đánh giá LLM theo 3 khía cạnh Mạnh, Yếu và Rủi ro cho kết quả như sau:
- Mạnh: LLM viết được văn bản rõ ràng, dễ hiểu cho nhiều nhóm người đọc và làm tốt những nhiệm vụ đã được huấn luyện.
- Yếu: Theo Google, LLM bị ảo giác, tức là dự đoán thường chứa lỗi, đồng thời có thể mang đủ loại thiên lệch như mọi mô hình học máy khác.
- Rủi ro: Doanh nghiệp có thể đưa câu trả lời sai vào nội dung công khai hoặc để lộ dữ liệu nội bộ khi dán vào công cụ AI dùng gói cá nhân.
Những thiên lệch này không xuất hiện ngẫu nhiên. Google lưu ý rằng LLM thường mang thiên lệch của chính tập dữ liệu đã dùng để huấn luyện mô hình.
Vì vậy, câu trả lời về một ngành hẹp hoặc một thị trường ít dữ liệu như Việt Nam cần được kiểm tra kỹ hơn. Để giúp doanh nghiệp phòng tránh sai sót, 2 phần dưới đây sẽ đi vào vấn đề ảo giác và an toàn dữ liệu.
Vì Sao LLM Bị Ảo Giác?
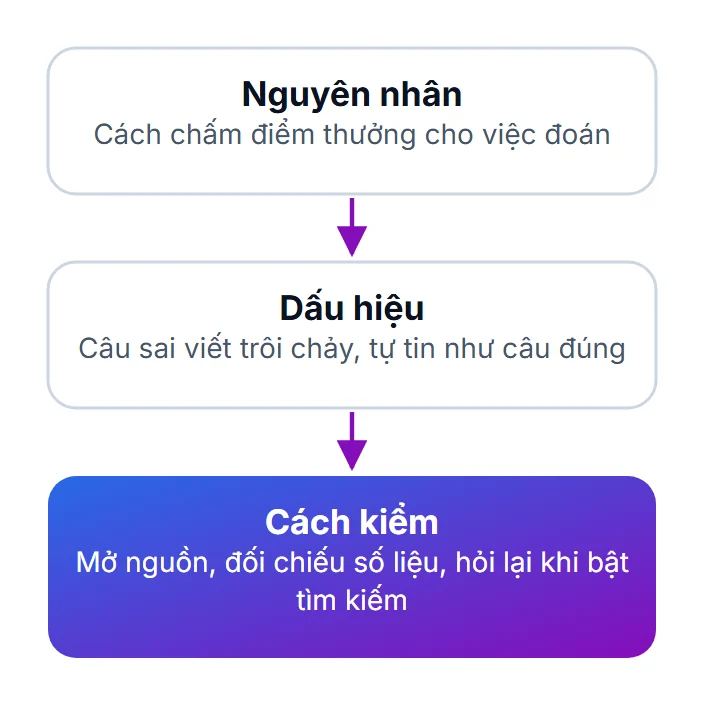
Ảo giác (hallucination) là khi LLM tự tin đưa ra một câu trả lời nghe hợp lý nhưng sai. Theo nghiên cứu OpenAI công bố ngày 05/09/2025, nguyên nhân nằm ở cách huấn luyện và chấm điểm hiện nay, vốn thưởng cho việc đoán thay vì thưởng cho việc thừa nhận không chắc chắn.
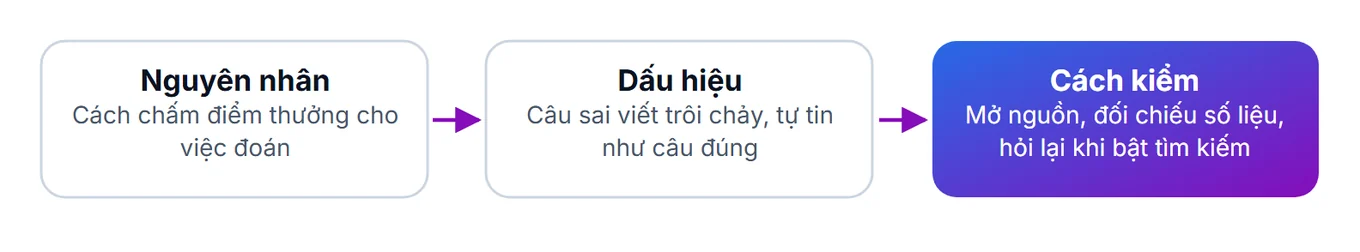
OpenAI giải thích bằng một ví dụ đơn giản. Khi được hỏi ngày sinh của một người mà mô hình không biết, câu đoán “ngày 10/9” có 1/365 cơ hội đúng, còn câu “tôi không biết” chắc chắn nhận 0 điểm.
Khi bài kiểm tra chỉ chấm độ chính xác, mô hình học được rằng đoán có lợi hơn im lặng. Hệ quả là câu trả lời sai thường được viết trôi chảy và tự tin giống như câu trả lời đúng.
Để kiểm tra một câu trả lời của LLM trước khi dùng, người đọc có thể thực hiện 3 việc sau:
Google mô tả grounding giúp câu trả lời chính xác hơn, nhưng bước tìm kiếm không loại bỏ được hoàn toàn ảo giác. Chính vì vậy, nội dung nào sắp xuất bản cũng cần một người kiểm tra lại.
Không Nên Dán Dữ Liệu Nào Vào Công Cụ AI?
Doanh nghiệp không nên dán thông tin mật, dữ liệu khách hàng, hợp đồng hoặc số liệu tài chính chưa công bố vào công cụ AI dùng gói cá nhân. Ở gói Free, Plus và Pro, OpenAI ghi rõ hãng có thể dùng nội dung của bạn để huấn luyện mô hình trừ khi bạn tắt tùy chọn này.
Để tắt tính năng này, người dùng vào mục Cài đặt (Settings), chọn Kiểm soát dữ liệu (Data controls) trong ChatGPT rồi tắt mục Cải thiện mô hình cho mọi người (Improve the model for everyone).
Theo mặc định, OpenAI không dùng dữ liệu đầu vào và đầu ra của ChatGPT Business, ChatGPT Enterprise, ChatGPT Edu và API để cải thiện mô hình.
Chính sách của mỗi hãng khác nhau và có thể thay đổi theo thời gian. Dù sử dụng gói nào, nguyên tắc an toàn nhất vẫn là không dán thông tin mật vào bất kỳ công cụ AI nào.
Ứng Dụng LLM Trong Marketing Và SEO Khi Có Người Duyệt
Trong marketing và SEO, LLM làm tốt các việc xử lý ngôn ngữ như nghiên cứu sơ bộ, lập dàn ý, tóm tắt tài liệu, phân nhóm từ khóa và viết bản nháp. Ngược lại, những việc cần số liệu chính xác, quyết định chiến lược hoặc nội dung đứng tên doanh nghiệp vẫn cần người duyệt trước khi dùng.
Bảng dưới đây tổng hợp 5 việc thường giao cho LLM, phần LLM làm được và điểm người duyệt cần kiểm tra:
| Việc | LLM làm được | Người duyệt cần kiểm |
|---|---|---|
| Nghiên cứu sơ bộ chủ đề | Tổng hợp nhanh các ý chính và những câu hỏi người đọc thường đặt ra | Mở nguồn gốc, kiểm tra từng số liệu và mốc ngày |
| Lập dàn ý | Đề xuất khung heading theo ý định tìm kiếm | Đối chiếu với kết quả tìm kiếm thực tế và bỏ phần người đọc đã biết |
| Tóm tắt tài liệu | Rút ý chính của báo cáo hoặc biên bản dài | Đối chiếu với bản gốc, nhất là các con số |
| Phân nhóm từ khóa | Gom từ khóa theo cùng ý định tìm kiếm | Kiểm tra lượng tìm kiếm bằng công cụ SEO vì LLM không có số liệu tìm kiếm thật |
| Viết bản nháp | Viết nhanh bản đầu theo dàn ý đã duyệt | Thêm trải nghiệm thực tế, kiểm chứng dữ kiện và chỉnh theo giọng thương hiệu |
Điểm chung của 5 việc trong bảng là LLM làm phần nháp nhanh, còn con người chịu trách nhiệm về độ chính xác. Chất lượng phần nháp phụ thuộc nhiều vào cách giao việc. Do đó, viết prompt nêu rõ mục tiêu, bối cảnh và định dạng là kỹ năng nên học trước tiên.
Ngược lại, có 3 nhóm việc không nên giao trọn cho LLM gồm:
- Số liệu không có nguồn: Mọi con số dùng trong báo cáo hoặc bài viết phải truy xuất được về nguồn gốc, còn LLM chỉ nên gợi ý chỗ cần tìm.
- Kết luận chuyên môn: Nhận định về pháp lý, thuế, y tế hoặc tài chính cần người có chuyên môn trực tiếp chịu trách nhiệm.
- Cam kết với khách hàng: Bảng báo giá, thời hạn và điều khoản gửi khách hàng phải do người có thẩm quyền duyệt.
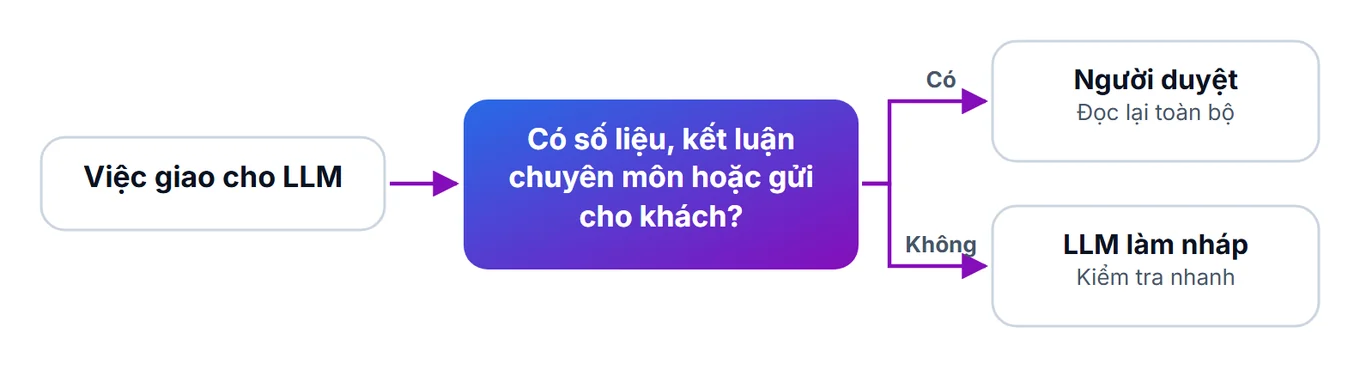
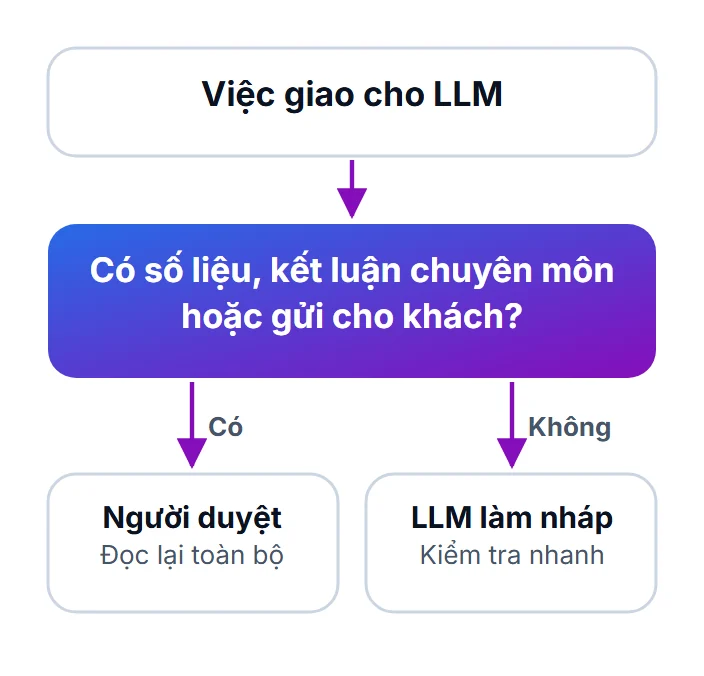
Một việc càng gần với quyết định kinh doanh hoặc với khách hàng thì càng cần người duyệt kỹ. Đối với việc nội bộ như tóm tắt hoặc phân nhóm từ khóa, một lượt kiểm tra nhanh thường là đủ. Đối với báo giá, bài đăng đứng tên doanh nghiệp hoặc báo cáo gửi khách hàng, người duyệt cần đọc lại toàn bộ.
Chiều ngược lại của câu chuyện là làm sao để LLM nhắc tới và trích dẫn website của doanh nghiệp khi khách hàng đặt câu hỏi. Đó là phạm vi của GEO (Generative Engine Optimization), dựa trên chính 2 nguồn kiến thức của LLM gồm nội dung có trong dữ liệu huấn luyện và nội dung được truy xuất lúc trả lời.
Việc hiểu LLM là gì giúp doanh nghiệp đọc đúng câu trả lời của AI về thương hiệu của mình. Câu trả lời đó đến từ dữ liệu huấn luyện đã có mốc cắt hoặc từ những trang được truy xuất ngay lúc hỏi.
Ngay trong tuần này, doanh nghiệp có thể mở Google Search Console để kiểm tra xem các trang dịch vụ quan trọng đã được lập chỉ mục chưa. Sau đó, người phụ trách có thể hỏi một công cụ AI có bật tìm kiếm về thương hiệu rồi so sánh câu trả lời với nội dung trên website.
Câu Hỏi Thường Gặp Về LLM
Trong ngành luật, LLM là bằng Thạc sĩ Luật và không liên quan tới AI. LLM API là giao diện để phần mềm gửi văn bản tới mô hình, chi phí tính theo token. Phần lớn doanh nghiệp không cần tự huấn luyện LLM mà dùng mô hình có sẵn kết hợp RAG trên tài liệu nội bộ.
LLM Là Gì Trong Luật?
Trong ngành luật, LLM là bằng Thạc sĩ Luật (Master of Laws), viết tắt từ tên Latin của văn bằng là Legum Magister, trong đó legum là dạng số nhiều của lex nghĩa là luật. Nghĩa này không liên quan tới mô hình ngôn ngữ lớn trong AI mà 2 khái niệm chỉ trùng nhau ở cách viết tắt.
LLM API Là Gì?
LLM API là giao diện lập trình (API) giúp phần mềm gửi văn bản tới LLM và nhận câu trả lời thay vì người dùng gõ vào khung chat. Chi phí tính theo số token đầu vào và đầu ra. OpenAI niêm yết GPT-6 Astra giá 10 USD cho mỗi 1 triệu token đầu vào tính đến tháng 10/2026.
Doanh nghiệp thường sử dụng API khi muốn đưa LLM vào hệ thống website, phần mềm chăm sóc khách hàng hoặc quy trình xử lý tài liệu nội bộ.
Doanh Nghiệp Có Cần Tự Huấn Luyện LLM Riêng Không?
Không, phần lớn doanh nghiệp không cần tự huấn luyện LLM từ đầu vì việc này cần dữ liệu khổng lồ, nhiều tháng tính toán và nhiều điện năng. Cách phổ biến hơn là dùng mô hình có sẵn kết hợp RAG trên tài liệu nội bộ, còn tinh chỉnh chỉ cần khi có nhiệm vụ hẹp lặp lại.
Các hãng cung cấp mô hình có sẵn qua API hoặc qua gói doanh nghiệp. Nhận định doanh nghiệp không cần tự huấn luyện là của đội ngũ GTV SEO dựa trên tài liệu của Google, không phải là kết quả đo lường.
GTV SEO – SEO & GEO Agency
Được tìm thấy trên Google. Được chọn trong câu trả lời AI.
Nguồn tham khảo
21
Danh mục tài liệu tham khảo của bài viết bao gồm các trang chính thức của những hãng AI như Google, OpenAI, Anthropic, Meta cùng các công trình nghiên cứu học thuật gốc về Transformer và RAG. Dưới đây là 21 nguồn đã được đội ngũ GTV SEO truy cập và kiểm tra vào ngày 30/10/2026:
- Google for Developers, Machine Learning Crash Course, “LLMs: What’s a large language model?”: https://developers.google.com/machine-learning/crash-course/llm/transformers
- Google for Developers, Machine Learning Crash Course, “Introduction to Large Language Models”: https://developers.google.com/machine-learning/crash-course/llm
- OpenAI Developers, “Models”: https://developers.openai.com/api/docs/models
- Claude Docs, “Models overview”: https://platform.claude.com/docs/en/models/overview
- Vaswani và cộng sự, “Attention Is All You Need” (arXiv, 12/06/2017): https://arxiv.org/abs/1706.03762
- Google for Developers, Machine Learning Crash Course, “LLMs: Fine-tuning, distillation, and prompt engineering”: https://developers.google.com/machine-learning/crash-course/llm/tuning
- Lewis và cộng sự, “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” (arXiv, 22/05/2020): https://arxiv.org/abs/2005.11401
- Google AI for Developers, “Gemini 4 Argon”: https://ai.google.dev/gemini-api/docs/models/gemini-4-argon
- Google AI for Developers, “Grounding with Google Search”: https://ai.google.dev/gemini-api/docs/google-search
- Perplexity Help Center, “How does Perplexity work?”: https://www.perplexity.ai/help-center/en/articles/10352895-how-does-perplexity-work
- Google Search Central, “AI features and your website”: https://developers.google.com/search/docs/appearance/ai-features
- OpenAI Developers, “Overview of OpenAI Crawlers”: https://developers.openai.com/api/docs/bots
- Perplexity, trang Perplexity Pro: https://www.perplexity.ai/pro
- Meta, “Llama”: https://dev.meta.ai/llama
- Meta, trang Meta Model API: https://dev.meta.ai/
- DeepSeek API Docs, “DeepSeek-V4.1-Flash-1017”: https://api-docs.deepseek.com/news/news261017
- Alibaba Cloud Model Studio, “Recommended models”: https://www.alibabacloud.com/help/en/model-studio/models
- Viettel AI, “Viettel huấn luyện mô hình AI chủ quyền tiếng Việt 120 tỷ tham số”: https://viettelai.vn/tin-tuc/viettel-trains-120-billion-parameter-vietnamese-sovereign-ai-model
- OpenAI, “Why language models hallucinate” (05/09/2025): https://openai.com/index/why-language-models-hallucinate/
- OpenAI Help Center, “How your data is used to improve model performance”: https://help.openai.com/en/articles/5722486-how-your-data-is-used-to-improve-model-performance
- USC Gould School of Law, “Master of Laws (LLM) Degree Programs”: https://gould.usc.edu/academics/degrees/llm/
Do tên mô hình, mốc dữ liệu và chính sách của các hãng AI thay đổi thường xuyên, bạn hãy mở lại trực tiếp trang nguồn khi cần đối chiếu thông tin mới nhất.